
硅基流动 SiliconCloud 上线 Qwen3-Embedding & Reranker 系列模型
随着 RAG 应用的不断深入,开发者对于 Embedding 与 Reranker 模型在文本表征、检索与排序等任务中的表现提出了更高要求。
为了助力开发者构建更强大的 RAG 系统,硅基流动 SiliconCloud 上线阿里巴巴通义千问团队最新发布的 Qwen3-Embedding-8B/4B/0.6B 和 Qwen3-Reranker-8B/4B/0.6B 系列模型。该系列模型基于 Qwen3 基础模型训练而成,不仅在多语言文本理解方面延续了 Qwen3 的卓越能力,也在信息检索等场景中展现出优异性能,能够为开发者提供更精准、高效的向量表示支持。
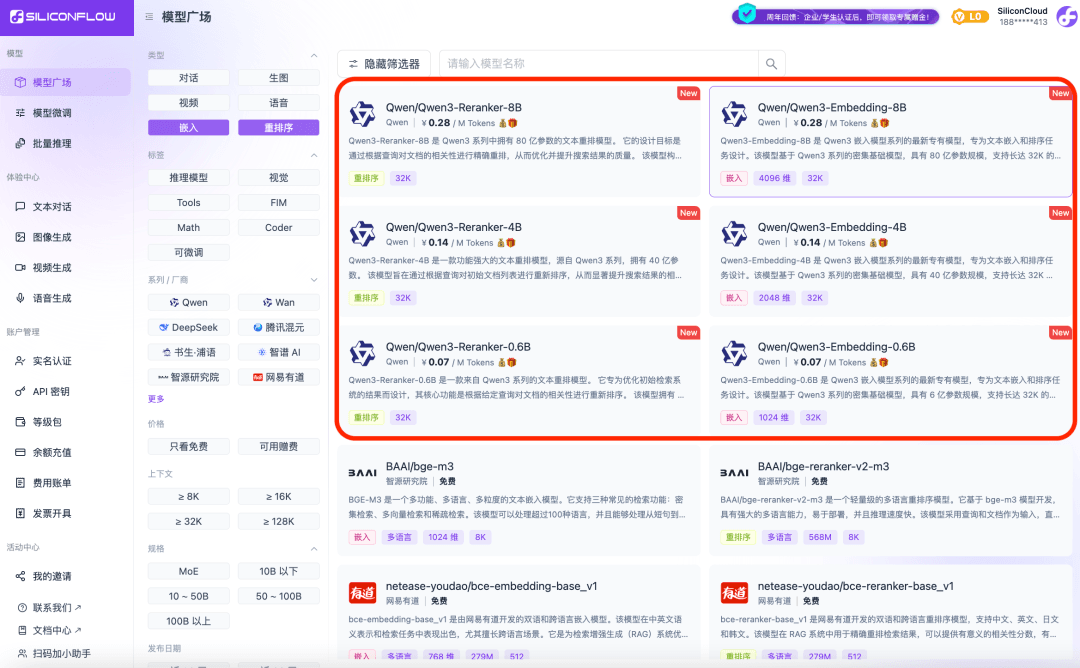
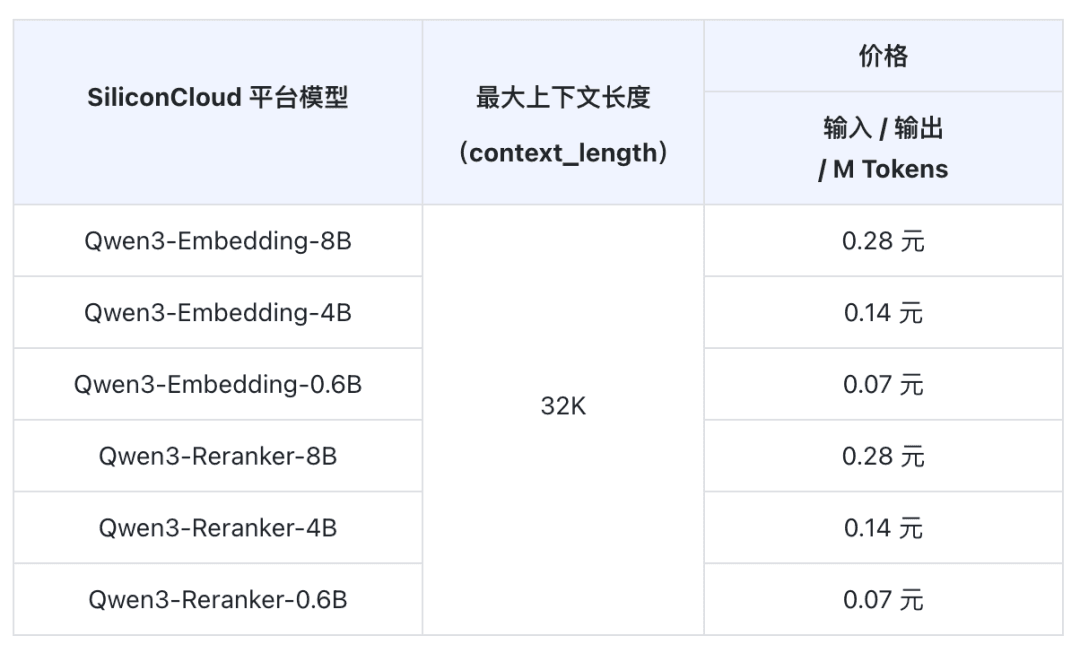
除本次上新的 Qwen3-Embedding & Reranker 系列模型外,平台也支持 BGE、BCE 等其他主流嵌入与排序模型,部分模型可免费使用。开发者可利用上述模型构建 RAG 能力,其中 Embedding 模型可视为“初筛”工具,快速定位潜在相关内容,而 Reranker 模型则承担着“精排”任务,进一步精准判断文本间的相关性。
Embedding API 文档:
https://docs.siliconflow.cn/cn/api-reference/embeddings/create-embeddings
Reranker API 文档:
https://docs.siliconflow.cn/cn/api-reference/rerank/create-rerank
模型特点及性能
基于 Qwen3 基础模型,Qwen3-Embedding 系列采用双塔结构设计,通过 LoRA 微调最大限度地保留并继承了基础模型的文本理解能力。在训练方面,该系列继承了 GTE-Qwen 系列的多阶段训练范式,但针对具体应用场景进行了深度优化,有效平衡了模型的泛化能力与任务适配性。
得益于这种架构设计和训练策略,Qwen3-Embedding 系列展现出三大核心优势:
-
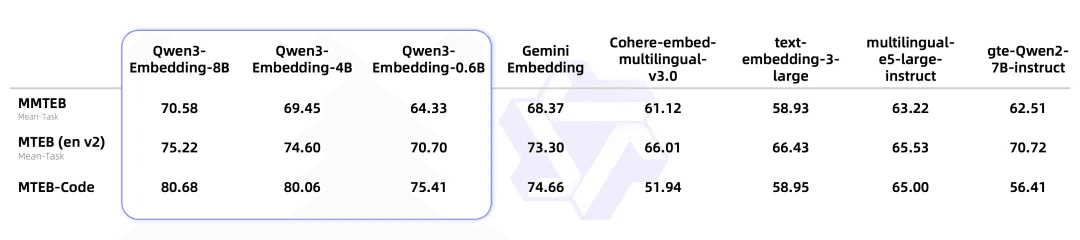
卓越的泛化性能:在多个下游任务评估中达到行业领先水平,其中8B参数规模的模型在MTEB多语言Leaderboard榜单中位列第一(截至2025年6月6日,得分70.58),性能超越众多商业API服务。Reranker 模型在各类文本检索场景中表现出色,显著提升了搜索结果的相关性;
-
灵活的模型架构:提供从 0.6B 到 8B 参数规模的 3 种模型配置,满足不同场景下的性能与效率需求,开发者可灵活组合表征与排序模块实现功能扩展。同时,模型支持表征维度自定义和指令适配优化,有效降低应用成本并提升特定场景下的性能表现;
-
全面的多语言支持:支持超过 100 种语言,涵盖主流自然语言及多种编程语言,具备强大的多语言、跨语言及代码检索能力,能够有效应对多语言场景下的数据处理需求。
多项基准测试结果也印证了 Qwen3-Embedding 系列的性能表现,在MMTEB 多语言检索任务、MTEB 英文检索任务、MTEB-Code 代码检索专项测试中可比肩 Gemini Embedding、Cohere-embed-multilingual-v3.0 等模型。
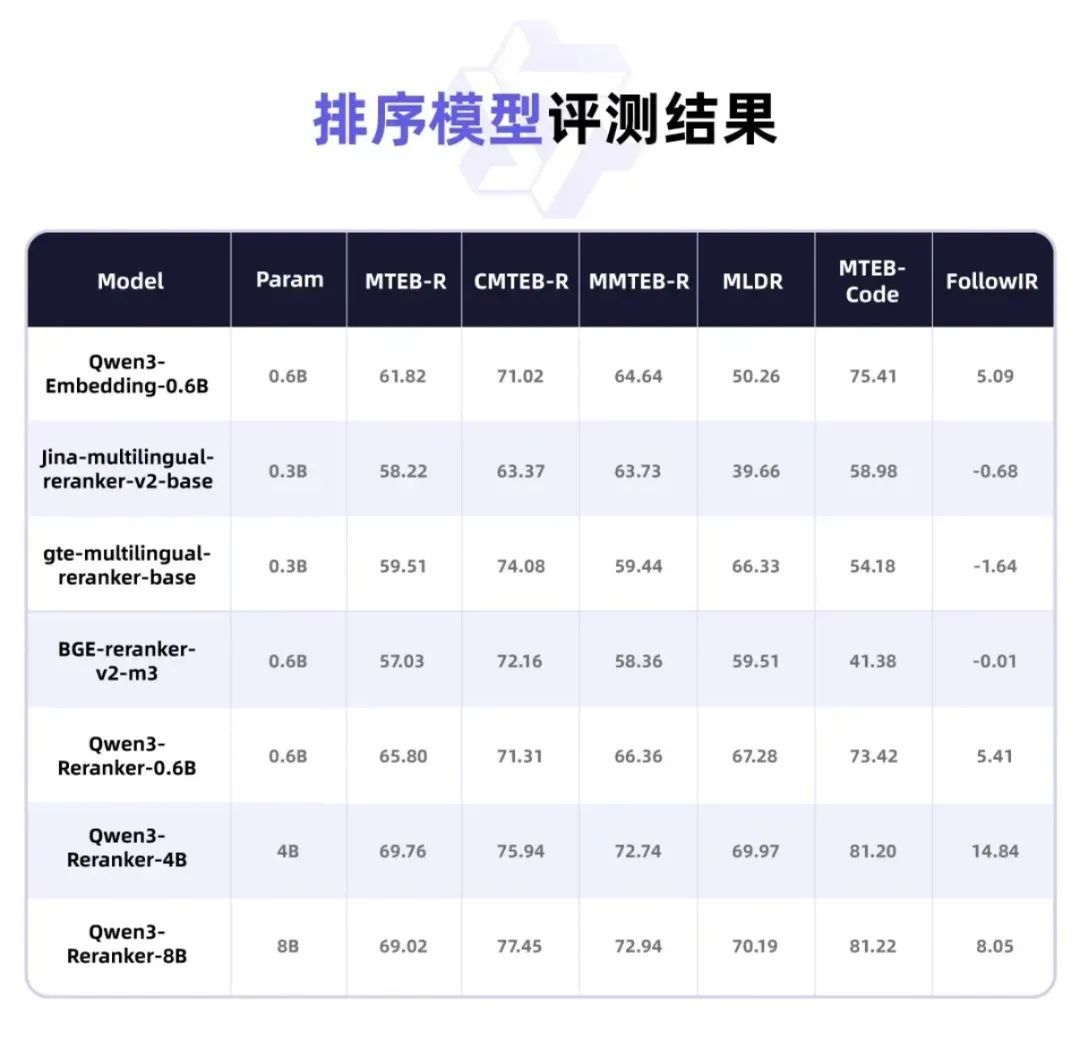
Qwen3-Reranker 系列模型在架构上采用了单塔设计,并在后续训练中,通义千问团队基于大量实验结果,选择直接利用高质量标注数据进行监督训练。这不仅提升了训练效率,也显著增强了模型的性能表现。具体来看,Qwen3-Reranker 系列在多个排序任务中表现出色,充分展示了其卓越的排序能力和良好的泛化性能。
现在,你可以通过调用 SiliconCloud 平台的 API 使用 Qwen3-Embedding & Reranker 系列模型了。